
请收下这份小小的Token
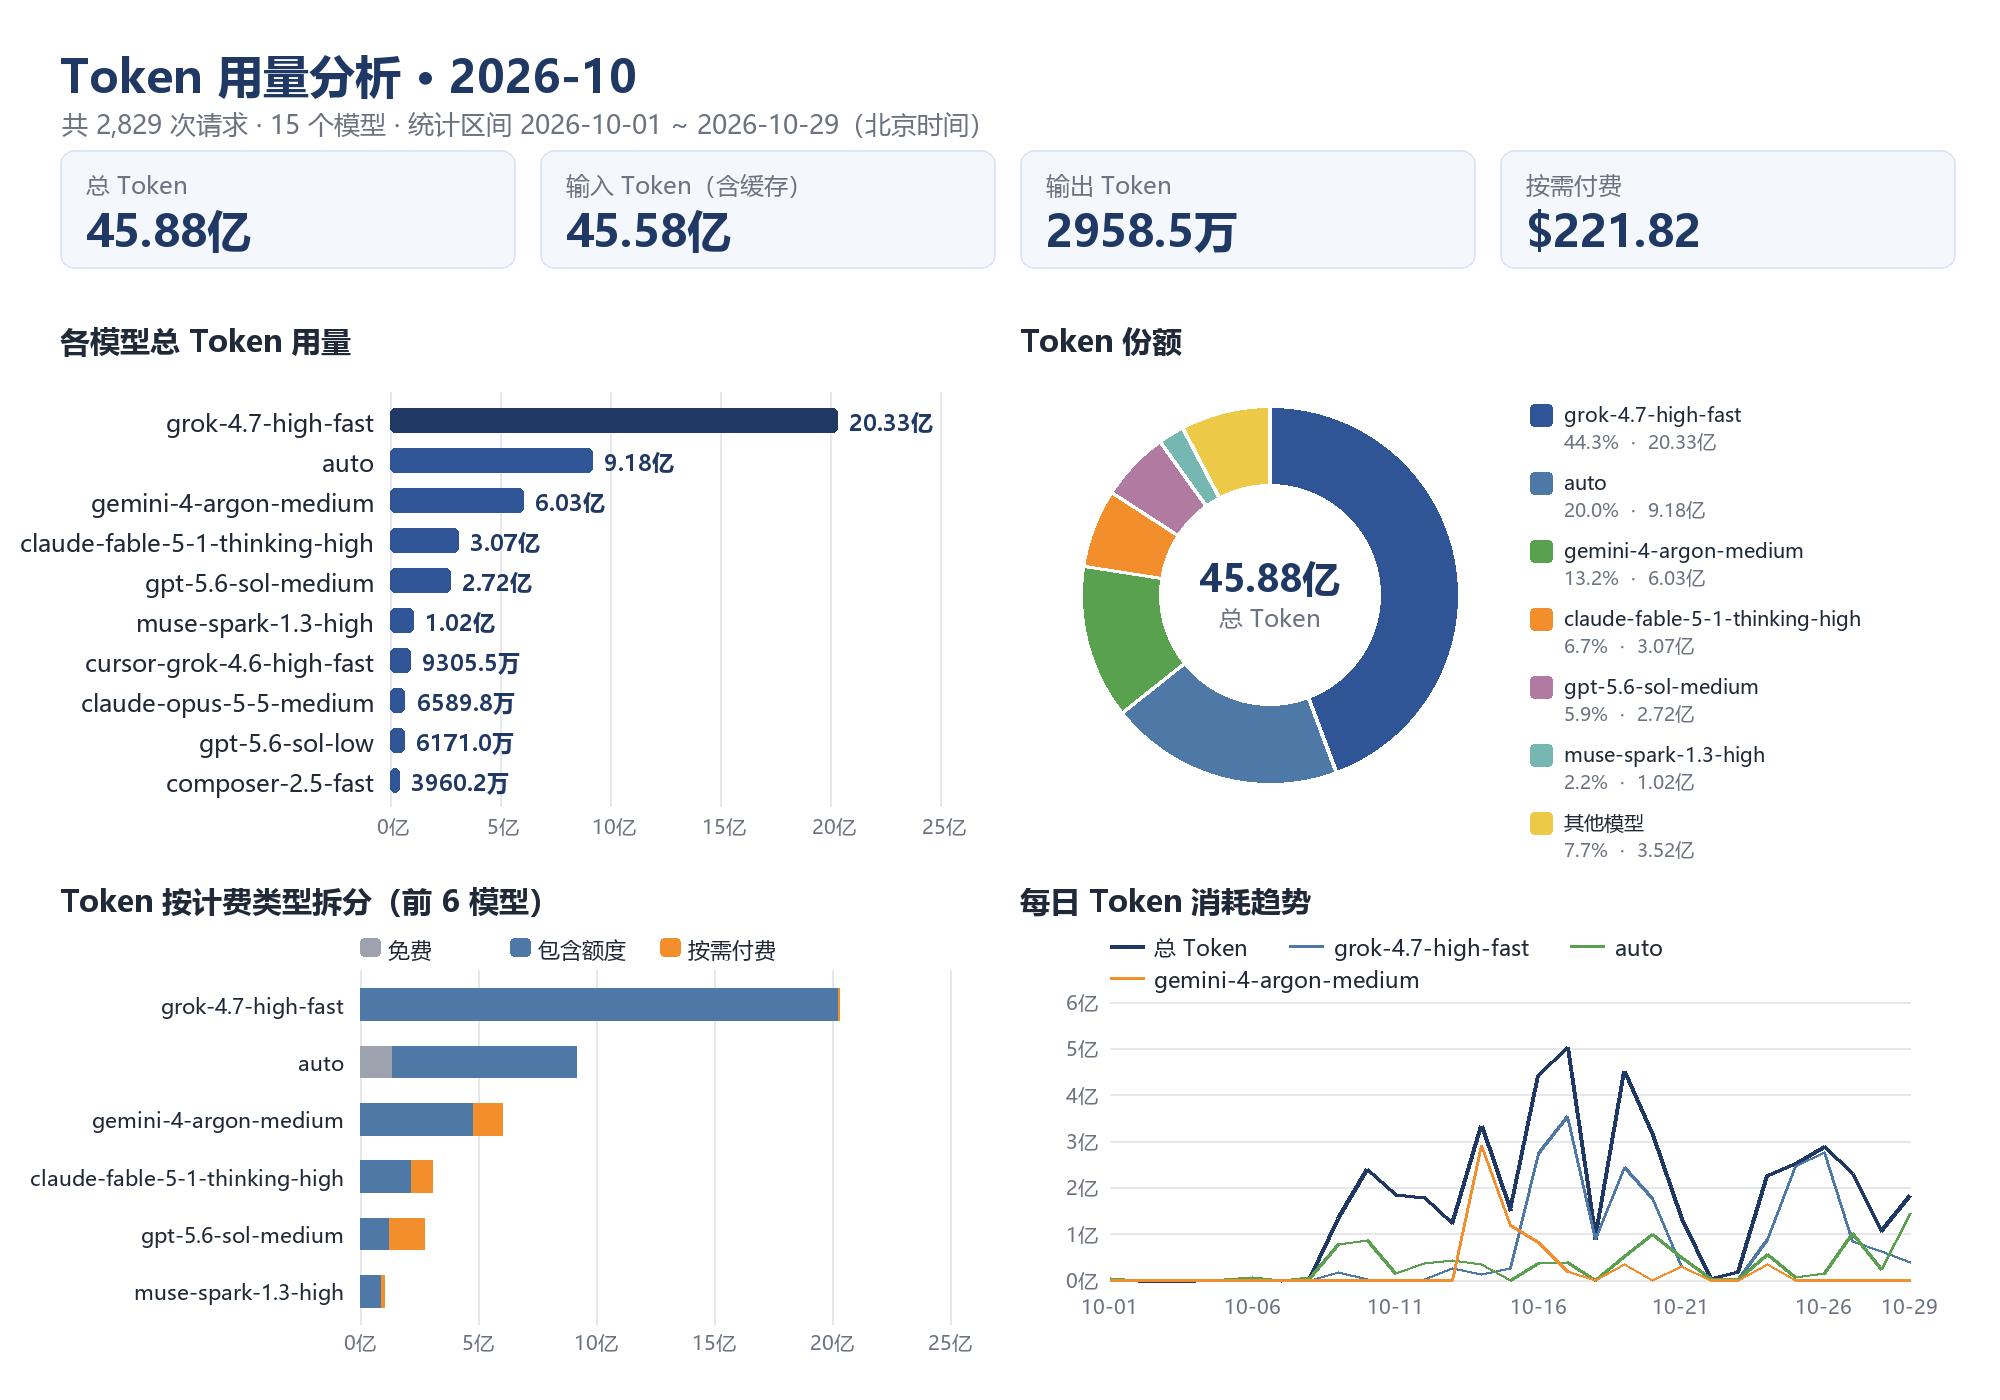
这是我司十月份的Cursor Token用量统计
需要注意的是,十月第一周是放假一周的
因此上述用量实际是仅三周的用量
而且,就我自己使用来看
绝大部分时间是等待时间,即输入问题后,大部分时间都是在等待回复的过程中
即,模型返回结果的过程中,吐字的速度受限了
我司内网部署的模型,每秒吐字260token左右
Cursor的模型大概也就这么多,如果十倍速度吐字,且token不限量的话
45亿用量再乘以10怕是都不够用的
接下来就看公司老板是否对当下AI价值是否肯定
以及愿意支付的上限
目前的情况是,不支出,一定无法产生实际价值
就是支出了,也不见得有多大产出
这个主要与实际用户有关
看用户是否能切到要害
切到要害就能尽可能的减少啰嗦节省token用量
当然了,我感觉大多数时候都是模型没有理解我的意思
因为很多时候,我都给模型截图了,画箭头了,挪到指定位置都要反复修改
还有一个就是记忆问题,由于上下文太长
改着后面的,忘记前面的
经常就一个问题反复修改,这就非常要命了
什么时候ai看我一个眼神就知道我要干啥
那才是真的智能
随着AI的进步,很多之前的理想都可以实现
例如许愿式编程
以前想要什么软件工具
只要有厉害的模型,几乎都能实现
关键结论
1.
用量高度集中:grok-4.7-high-fast、auto、gemini-4-argon-medium 三个模型合计占总 Token 的
77.5%;其中 grok-4.7-high-fast 以 938 次请求消耗 20.33 亿 Token,是绝对主力。
2.
缓存是成本关键:整体缓存命中率 95.9%(缓存读取 43.72 亿 / 输入合计 45.58 亿),缓存读取已超过未缓存输入,说明长上下文复用充分。
3.
输出小而精:输出 Token 仅 0.30 亿,占总 Token 的 0.6%,输入输出比约 154:1。
4.
付费占比低:仅 9.2% 的 Token 走按需付费,实际付费 $221.82;其余 90.8% 由免费额度与订阅包含额度覆盖。
5.
单次消耗差异大:grok-4.7-high-fast 平均每次 2,167K Token,而 cursor-grok-4.6-medium 仅
283K,长上下文与轻量任务并存。

暂无评论